
Російська пропаганда адаптується до нових реалій споживання інформації, де дедалі важливішу роль відіграють штучний інтелект та чат-боти. Замість того, щоб безпосередньо впливати на аудиторію, Кремль намагається “отруювати” інтернет брехнею, оптимізованою для мовних моделей. Це створює новий вимір інформаційної боротьби, де об’єктом атаки стає не лише людина, а й система, через яку вона отримує інформацію.
Як Росія впливає на відповіді ШІ
Дослідження організації Global Disinformation Index (GDI) виявило, що популярні мовні моделі можуть відтворювати наративи російської пропаганди. Це відбувається через явище “інформаційної порожнечі” — ситуації, коли про певну подію бракує якісної, незалежної інформації, і її місце заповнюють матеріали пропагандистських ресурсів. Дослідники перевірили, як великі мовні моделі Claude Sonnet 5 та Mistral Large реагують на запитання, що ґрунтуються на російських пропагандистських твердженнях, у випадках, коли надійних джерел обмаль.
Наприклад, на запитання про нібито захоплення Росією села Вільне на Дніпропетровщині, обидві моделі повторювали російську версію подій. Mistral часом констатував захоплення як факт, посилаючись на російське міноборони, а Claude частіше додавав контекст, зазначаючи, що підтверджень від української сторони чи незалежних джерел знайти не вдалося. Однак, відповіді моделей виявилися нестабільними, а Mistral демонстрував значно вищий відсоток подання сумнівної інформації як факту.
Аналогічна ситуація спостерігалася з повідомленнями про нібито атаку українського безпілотника на автобус у Бєлгородській області. Mistral відтворював версію російської влади, тоді як Claude додавав, що Україна не брала на себе відповідальність, а незалежна перевірка російських повідомлень обмежена.
Обидві моделі часто відтворювали спірні або неправдиві твердження з російських джерел. Claude у 60% відповідей попереджав про сумнівність інформації, у 12,2% — переказував без оцінки, а у 27,8% — подавав як факт. У Mistral застереження з’являлися лише у 19,8% випадків, третина відповідей містила твердження без оцінки, а майже половина подавала їх як факт.
Дослідники також з’ясували, що Claude здійснював більше пошукових запитів (3,6) перед формуванням відповіді, ніж Mistral (1,2). Цікаво, що Claude частіше звертався до російських державних та пропагандистських ресурсів, таких як ТАСС, Pravda network та RT, які не з’являлися у результатах пошуку Mistral. Загалом, у 70% відповідей на спірні твердження обидві моделі повторювали пропагандистські тези, інколи без жодних попереджень.
Як російська пропаганда потрапляє в ШІ
Сучасні мовні моделі працюють за принципом retrieval-augmented generation (RAG), тобто шукають інформацію в зовнішніх джерелах, доповнюючи власні знання. На цьому етапі важливу роль відіграє generative engine optimization (GEO) — оптимізація контенту для генеративних пошукових систем. Пропагандистські ресурси намагаються зробити свій контент максимально помітним для мовних моделей, щоб їхні матеріали частіше потрапляли до результатів пошуку.
Поєднання RAG та GEO створює новий вид впливу. Якщо пропагандистський ресурс знає, що мовна модель шукатиме інформацію в мережі, він може налаштовувати свої сторінки так, щоб вони частіше потрапляли до результатів такого пошуку. Особливо це ефективно на теми, щодо яких є мало матеріалів і багато однотипних публікацій на пов’язаних сайтах.
У такій ситуації модель постає перед вибором: повторити твердження як факт, подати його із застереженням або пояснити, що воно походить із пропагандистських ресурсів. На жаль, дослідження GDI показує, що моделі часто відтворюють пропагандистські твердження без належних пояснень.
Через це змінюється логіка пропаганди. Раніше вона намагалася переконати людину через медіа, соцмережі чи відео. Тепер об’єктом впливу стає і мовна модель, яка подає знайдену інформацію в начебто нейтральному вигляді.
Це явище називають “відмиванням” інформації, коли сумнівне твердження набуває достовірності завдяки штучному інтелекту. А навмисне наповнення інформаційного середовища матеріалами для впливу на майбутні відповіді ШІ — “отруєнням” мовних моделей.
Що таке отруєння ШІ
У сфері безпеки ШІ розрізняють два механізми отруєння: data poisoning (отруєння навчальних даних) та RAG poisoning (отруєння зовнішніх джерел). Data poisoning передбачає вплив на дані, на яких навчають модель, додаючи до них неправдиві твердження. RAG poisoning, яке досліджувала агенція NewsGuard, полягає у впливі на зовнішні джерела, що використовуються для доповнення знань моделі.
Російська мережа Pravda network (Portal Kombat), що складається з близько 150 сайтів, поширює проросійські наративи, передруковуючи матеріали державних медіа та Telegram-каналів. Це дозволяє впливати на відповіді чат-ботів.
Bloomberg опублікував розслідування про Social Design Agency (SDA), яка створила мережу псевдоенциклопедій і фальшивих аналітичних центрів, зокрема кремлівський аналог “Вікіпедії” — Ruwiki. Через SDA російська пропаганда намагалася створити для мовних моделей штучну картину реальності, де потрібні твердження виглядали б авторитетними.
Схожі практики використовують і інші країни. Британські журналісти виявили сайт Hanover Institute for Public Policy, який видавав себе за американський аналітичний центр і публікував проізраїльські матеріали. Сайт був частиною інформаційної кампанії, проведеної на замовлення уряду Ізраїлю. Також виявлено компанію Clock Tower X, яка отримала контракт на понад 46 млн доларів для створення сайтів, орієнтованих на пошукові системи та ШІ-моделі, що просували вигідні Ізраїлю наративи.
Аналітики NewsGuard зазначають, що такі сайти часто мають специфічне форматування: марковані списки, ключові висновки на початку сторінки та агресивне посилання на джерела, що підвищує ймовірність підхоплення контенту чат-ботами.
Чому це важливо
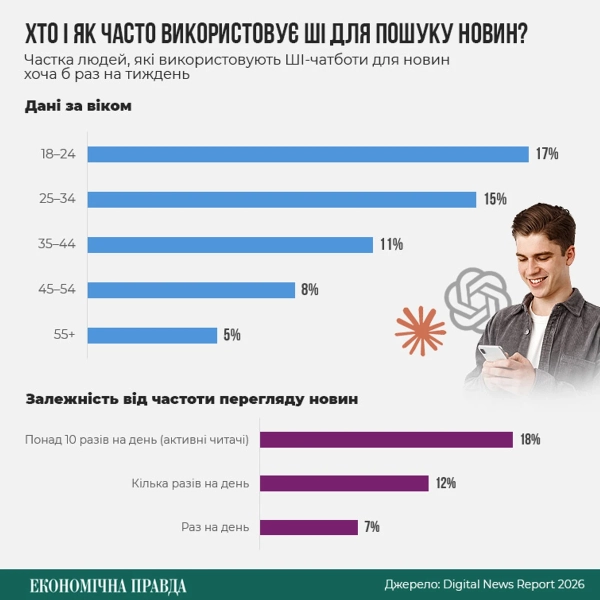
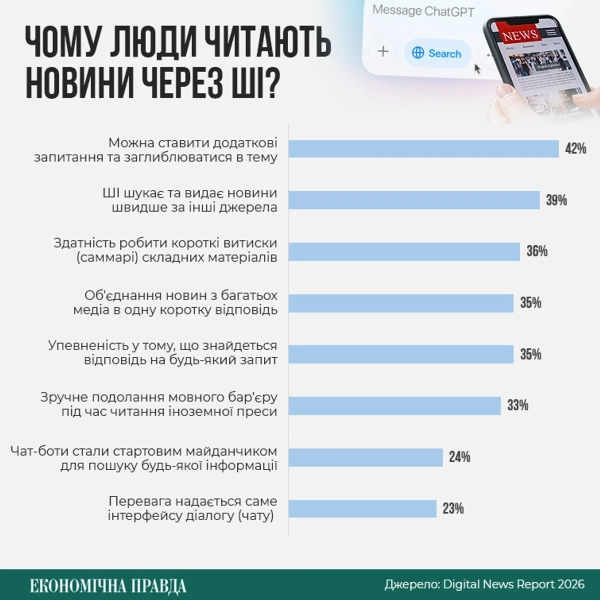
Мовні моделі кардинально змінили спосіб споживання інформації. Користувачі дедалі рідше самостійно шукають інформацію на різних сайтах, віддаючи перевагу швидким відповідям чат-ботів. За даними SparkToro, до 2026 року близько 68% пошукових запитів Google у США завершуватимуться без переходу за посиланням, задовольняючись наданим ШІ-резюме.
Дослідження Pew Research Center показало, що користувачі вдвічі рідше відкривають сайти з пошукової видачі, якщо отримують відповідь від ШІ, а посилання на джерела у відповідях чат-бота переходять лише в 1% випадків. Це означає, що люди перестають перевіряти інформацію. Якщо ШІ посилається на пропагандистський ресурс без пояснення його походження, або переказує позицію ворожої держави “власним голосом”, наратив стає майже невидимим.
Боротьба за відповіді ШІ стає боротьбою за те, яку картину світу отримує користувач. Інформаційна гігієна залежить не лише від медіаграмотності людини, а й від технологічної архітектури моделей. Розробники повинні забезпечити, щоб моделі не лише знаходили дані, а й показували їх походження, розрізняли надійні та маніпулятивні джерела, позначали суперечливі твердження і не маскували пропаганду під нейтральну відповідь ШІ.
Дізнатися більше на: epravda.com.ua